Recentemente, uma atividade significativa na comunidade de otimização de hardware resultou na remoção bem-sucedida das limitações computacionais das placas gráficas NVIDIA GeForce RTX, permitindo que o desempenho em tarefas de inteligência artificial e modelagem de linguagem aumente drasticamente. Essa modificação de software utiliza o poder de processamento dos Tensor Cores, potencializando a performance em computadores pessoais.
Desbloqueio das arquiteturas Ampère e Ada Lovelace
Tanto as placas GeForce RTX 30 quanto as RTX 40 compartilham o mesmo chip de silício utilizado em processadores para estações de trabalho, mas a NVIDIA implementou restrições em sua velocidade através de firmware. Com a remoção dessas barreiras, placas que eram convencionais agora alcançam velocidades de processamento semelhantes às de dispositivos especializados e mais caros.
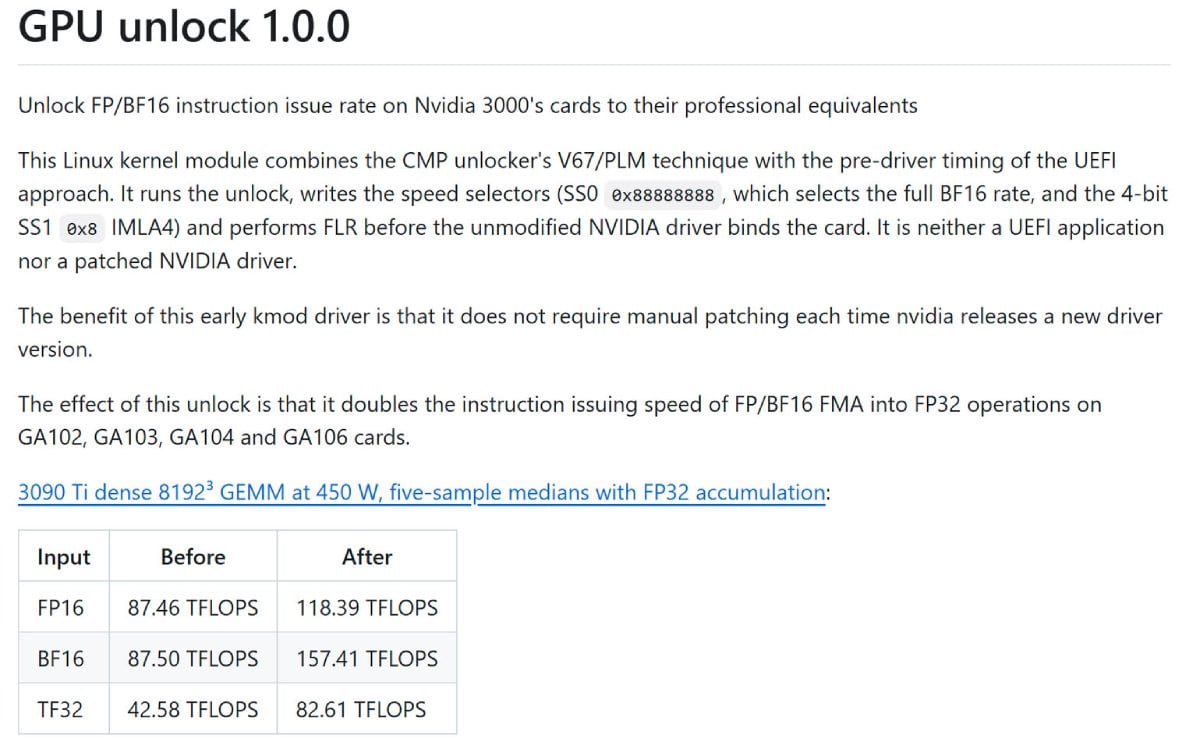
Para a arquitetura Ampere, a modificação consegue duplicar a velocidade de execução de instruções em cálculos de ponto flutuante (FP/BF16 FMA) para FP32. Essa modificação é compatível com várias litografias, como GA102, GA103, GA104 e GA106. Testes indicam que a GeForce RTX 3090 Ti pode aumentar a velocidade de multiplicação de matrizes no formato BF16 em até 80%, melhorando diretamente o desempenho de redes neurais artificiais.
Incremento da largura de banda na série RTX 40
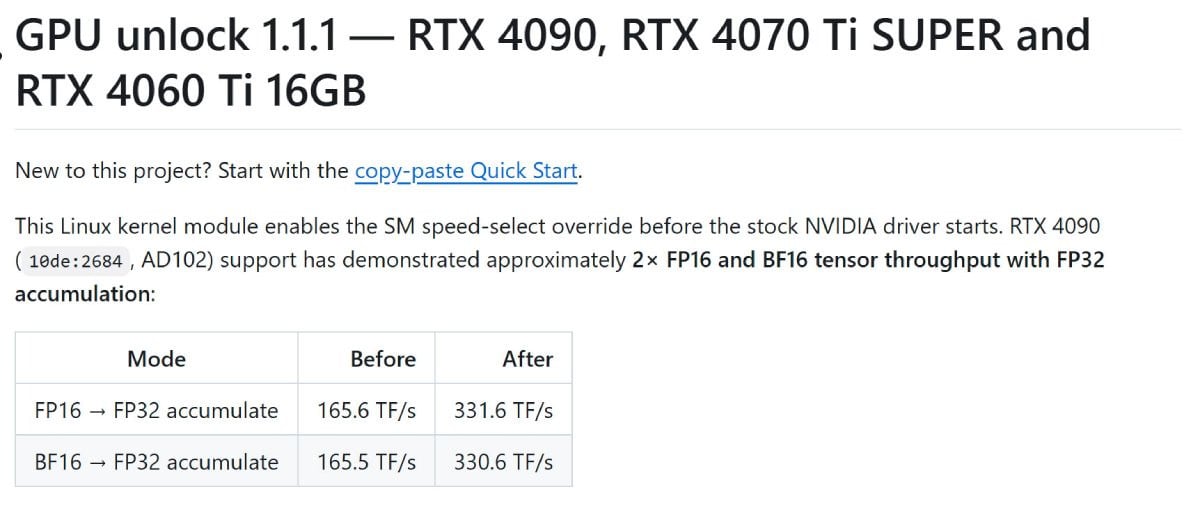
O desbloqueio teve um impacto significativo na linha GeForce RTX 40, incluindo núcleos AD102, AD103 e AD106. Em testes realizados com a GeForce RTX 4090, o processamento nos núcleos Tensor nos formatos FP16 e BF16 acumulou FP32 saltou de 165,6 TeraFLOPS para 331,6 TeraFLOPS, aproximando seu desempenho das placas NVIDIA RTX 6000 Ada Lovelace de última geração.
A evidência sugere que a NVIDIA impôs limitações de software às operações de multiplicação e acumulação de matrizes em seus núcleos AD102. Com a remoção dessas restrições, desenvolvedores podem otimizar o treinamento e a execução de inferências em grandes modelos de linguagem (LLMs).
| Modelos de Placas Gráficas | Índice Computacional | Antes da Intervenção | Após Intervenção |
|---|---|---|---|
| GeForce RTX 4090 (AD102) | O tensor FP16/BF16 acumula FP32 | 165,6 TeraFLOPS | 331,6 TeraFLOPS |
| GeForce RTX 3090 Ti (GA102) | Velocidade de multiplicação de matrizes no formato BF16 | Nível padrão | Aumento de 80% |
| GA102 e AD102 | Limite de Potência Gráfica (TGP) | 450 W | 450 W (constante) |
Mecanismos de engenharia e riscos da modificação de firmware
As arquiteturas Ampere e Ada Lovelace mantêm compatibilidade com as verificações de integridade de drivers da NVIDIA e conseguem ignorar o processo de reinicialização do nível de função (FLR) do PCIe. Dessa maneira, as placas continuam estáveis com drivers padrão e passam por todos os testes profissionais do kit de ferramentas CUDA sem erros.
Embora o aumento de desempenho seja considerável, essa abordagem apresenta limitações. O código executável precisa ser ativado durante a inicialização para estabelecer conexão antes que o driver interaja com o kernel do sistema operacional. Ademais, a intervenção no firmware resulta na anulação da garantia do fabricante.