A memória do NVIDIA RTX Spark utiliza uma arquitetura de memória unificada, que é compartilhada entre a CPU e a GPU integrada. Com um exemplo de 128 GB de memória, 96 GB podem ser alocados para a GPU, de acordo com a fórmula nominal da NVIDIA, que resulta em 32 GB restantes, divididos em 16 GB compartilhados e 16 GB dedicados à CPU.
Como a memória é organizada no Windows?
O sistema Windows apresenta a memória unificada em três regiões lógicas:
- Memória dedicada à GPU – é a parte alocada exclusivamente para uso da GPU.
- Memória compartilhada – parte acessível tanto pela CPU quanto pela GPU.
- Memória exclusiva da CPU – reservada apenas para a CPU, ideal para o Windows e aplicativos básicos.
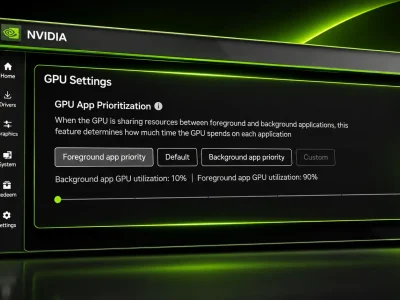
A alocação de memória para a GPU pode ser ajustada pelo aplicativo da NVIDIA, sendo recomendado reservar pelo menos 16 GB para garantir um desempenho estável do sistema e dos aplicativos.
O que acontece com 96 GB reservados para a GPU?
No caso de um laptop ASUS ProArt P16, que possui um total de 128 GB de memória, a alocação de 96 GB para a GPU deixa 32 GB disponíveis. Seguindo a lógica da NVIDIA, essa memória se divide em 16 GB compartilhados e 16 GB dedicados à CPU. Essa configuração é visualmente demonstrada em vídeos e gráficos que detalham a alocação.
| Região de memória | Quantidade nominal | Função |
| Memória física instalada | 128 GB | Conjunto total compartilhado pela CPU e pela GPU integrada |
| Alocação dedicada à GPU | 96 GB | Região reservada para a GPU |
| Saldo após a alocação | 32 GB | Memória restante, dividida entre as duas regiões abaixo |
| Memória compartilhada | 16 GB | Região acessível pela CPU e pela GPU |
| Memória exclusiva da CPU | 16 GB | Região disponível à CPU, ao Windows e a aplicativos básicos |
O que essa divisão permite na IA local?
A arquitetura permite que modelos de linguagem grandes (LLMs) e agentes de IA acessem memória adicional do sistema caso ultrapassem os limites da alocação dedicada à GPU, desde que o software suporte essa funcionalidade. No entanto, o acesso à memória compartilhada pode ser inferior em velocidade em comparação com a memória dedicada.
Essa estrutura de memória é destacada na documentação da NVIDIA, que diferencia claramente a memória compartilhada da total e ressalta a importância de entender como ela é utilizada em laptops RTX Spark.