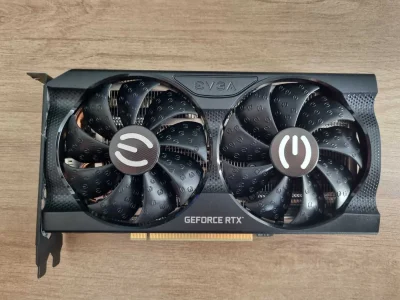
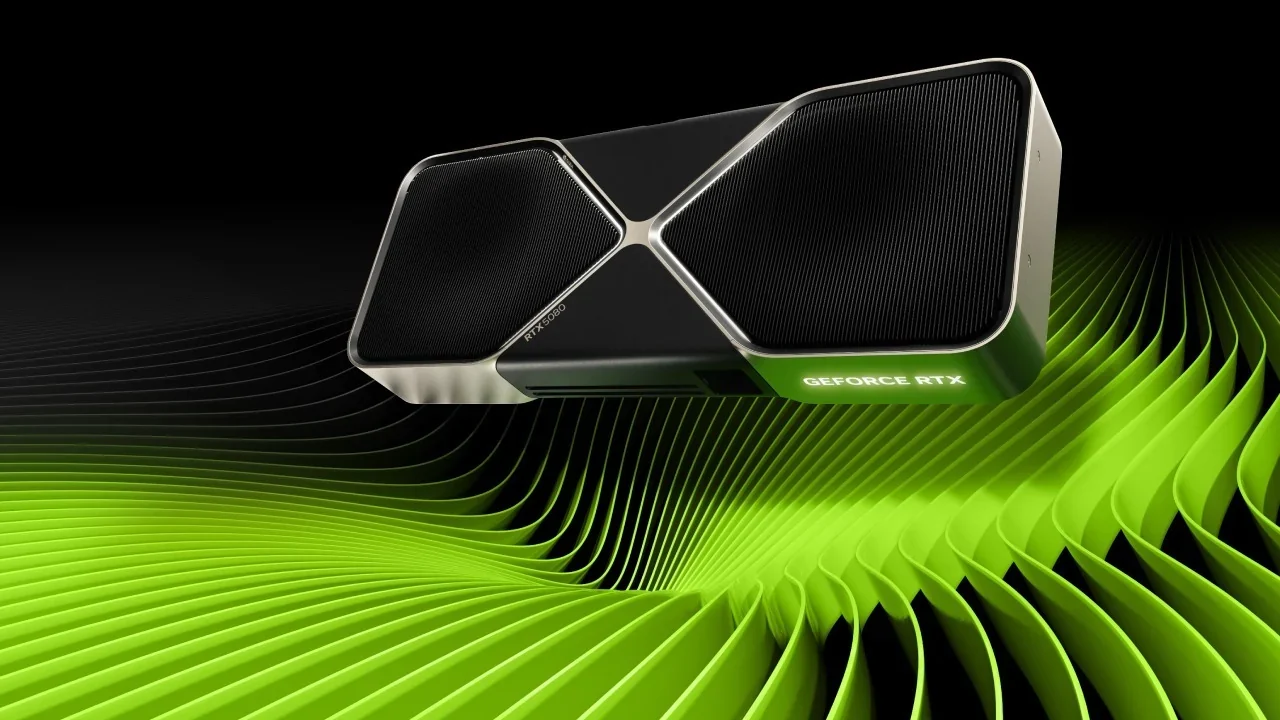
A NVIDIA ainda não forneceu medições oficiais que comparem a RTX 5080 à RTX 5090 em desempenho de inferência local até esta data. As especificações da RTX 5090 incluem 32 GB de GDDR7, 21.760 núcleos CUDA e um consumo de 575 W, mas a comparação efetiva entre estas placas requer medições práticas, principalmente para quem pretende utilizar modelos de linguagem em casa.
RTX 5080 e RTX 5090: o que está confirmado
A RTX 5080 e a RTX 5090 pertencem à geração Blackwell da NVIDIA. A RTX 5090 é atualmente o modelo topo de linha da série GeForce. Não há confirmações sobre versões “Super” ou “Ti”. O que se sabe é que a NVIDIA está promovendo outras arquiteturas, como a Vera Rubin, focadas em aplicações de machine learning em data centers, e não em lançamentos voltados para o consumidor comum.
A lista abaixo resume as principais características de ambas as placas:
| Característica | RTX 5090 | RTX 5080 |
|---|---|---|
| Arquitetura | Blackwell | Blackwell |
| Memória | 32 GB GDDR7, interface de 512 bits | A confirmar |
| Núcleos CUDA | 21.760 | A confirmar |
| Potência total da placa | 575 W | A confirmar |
| Preço de lançamento (EUA) | 1.999$ (30 jan 2025) | 999$ (30 jan 2025) |
Como medir a eficiência das placas
Para comparar a eficiência das placas, você precisará considerar cinco medições principais: velocidade de leitura de prompts, velocidade de geração, potência média, tokens por watt e energia por mil tokens. A ferramenta llama.cpp e o utilitário nvidia-smi são necessários para obter esses dados. O processo é feito em 12 passos e leva cerca de 75 minutos por placa.
Pré-requisitos e configurações para o teste
Utilize um PC com RTX 5080 ou RTX 5090, com a fonte e o sistema operacional adequados. A configuração recomendada é:
| Componente | Versão ou requisito | Nota |
|---|---|---|
| Sistema operativo | Windows 11 64 bits ou Ubuntu 24.04 LTS | Usar o mesmo nos dois PCs |
| Driver NVIDIA | Game Ready 621.24 WHQL ou superior | Lançado a 12 nov 2026 |
| CUDA Toolkit | 13.5 | Publicado a 4 nov 2026 |
| llama.cpp | Versão mais recente do ramo principal | Compilada com GGML_CUDA |
| CMake | 3.28 ou superior | Ferramenta de compilação |
| Compilador | Visual Studio 2022 ou GCC 13 | Windows ou Linux |
| Python | 3.11 ou superior | Os scripts usam apenas a biblioteca padrão |
| Espaço em disco | 60 GB livres | Para modelos GGUF |
Execução do teste
O teste deve ser realizado em etapas. Aqui está um resumo dos passos importantes:
- Defina as métricas.
- Prepare o PC, desativando aplicações que usam GPU.
- Instale o driver e o CUDA Toolkit.
- Compile o llama.cpp.
- Escolha modelos que podem ser carregados na VRAM.
- Execute o llama-bench manualmente para garantir funcionalidade.
- Automatize a coleta de dados com um script para comparar tokens por watt.
Resultados e comparações
Após a execução, você poderá comparar os dados de desempenho em um CSV gerado pelo script. Compare os FPS, consumo e eficiência em diverse modos e limites de potência. Documente os resultados para verificar a relação de desempenho entre as placas.
Possíveis erros e solução de problemas
- Evite comparar quantizações diferentes entre modelos.
- Não meça imediatamente após ligar o PC, pois isso pode resultar em leituras imprecisas.
- Verifique se o limite de potência não foi alterado acidentalmente durante o teste.
- Use o nvidia-smi para confirmar dados de energia corretos.
Esse guia fornece uma metodologia para entender melhor o desempenho da RTX 5080 e RTX 5090 em aplicações de IA, permitindo decisões fundamentadas sobre qual placa adquirir ou utilizar.